
مقدمه
فرض کنید در یک کتابخانه بزرگ به دنبال کتابی هستید، اما نه بر اساس عنوان دقیق، بلکه بر اساس موضوع و مفهوم. پایگاهدادههای سنتی برای این کار ساخته نشدهاند؛ آنها دنبال تطابق دقیق کلمات میگردند، نه معنا. اما در دنیای هوش مصنوعی امروز بهویژه در چتباتها و سامانههای پرسشوپاسخ ما دقیقاً به جستوجوی مبتنی بر معنا نیاز داریم. اینجاست که پایگاهداده برداری وارد میشود و به یکی از ارکان اصلی هوش مصنوعی مدرن تبدیل شده است.
در این مقاله توضیح میدهیم که پایگاهداده برداری چیست، مفهوم کلیدی "بردار" چگونه معنا را نمایندگی میکند، جستوجوی شباهت چطور کار میکند و چرا این فناوری قلب تپنده سامانههای RAG و چتباتهای اختصاصی است.
پایگاهداده برداری چیست؟
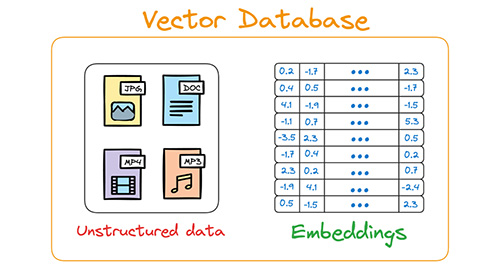
پایگاهداده برداری نوعی پایگاهداده تخصصی است که بهجای ذخیره داده در قالب جدولهای سنتی، اطلاعات را بهصورت بردار یعنی فهرستی از اعداد ذخیره میکند و امکان جستوجو بر اساس شباهت معنایی را فراهم میسازد. در حالی که یک پایگاهداده معمولی به پرسش "کدام ردیفها کلمه فلان را دارند؟" پاسخ میدهد، پایگاهداده برداری به پرسش بسیار قدرتمندتری پاسخ میدهد: کدام موارد از نظر معنا به این پرسش شبیهترند؟
این تفاوت بنیادین باعث شده پایگاهداده برداری به زیرساخت ضروری برنامههایی تبدیل شود که با دادههای بدون ساختار مانند متن، تصویر و صدا کار میکنند و نیاز به درک معنایی دارند.
بردار چیست و چرا مهم است؟
برای اینکه یک ماشین بتواند معنا را درک کند، باید داده (مثلاً یک جمله) را به زبانی که میفهمد، یعنی اعداد، تبدیل کنیم. این کار با فرایندی به نام جاسازی (Embedding) انجام میشود. یک مدل هوش مصنوعی، هر قطعه متن را به یک بردار عددی با ابعاد بالا (مثلاً فهرستی از صدها یا هزاران عدد) تبدیل میکند.
جستوجوی شباهت چگونه کار میکند؟
-
پرسش کاربر ابتدا با همان مدل جاسازی به یک بردار تبدیل میشود.
-
پایگاهداده برداری به دنبال بردارهایی میگردد که کمترین فاصله (بیشترین شباهت) را با بردار پرسش دارند.
-
نزدیکترین موارد بهعنوان مرتبطترین نتایج بازگردانده میشوند.
برای سنجش شباهت معمولاً از معیارهایی مانند «شباهت کسینوسی» استفاده میشود. اما یک چالش وجود دارد:
در پایگاهدادههای بزرگ با میلیونها بردار، مقایسه پرسش با تکتک آنها بسیار کند است.
به همین دلیل پایگاهدادههای برداری از الگوریتمهای هوشمندی به نام جستوجوی تقریبی نزدیکترین همسایه (ANN) استفاده میکنند که با کمی چشمپوشی از دقت مطلق، سرعت جستوجو را بهشدت افزایش میدهند.
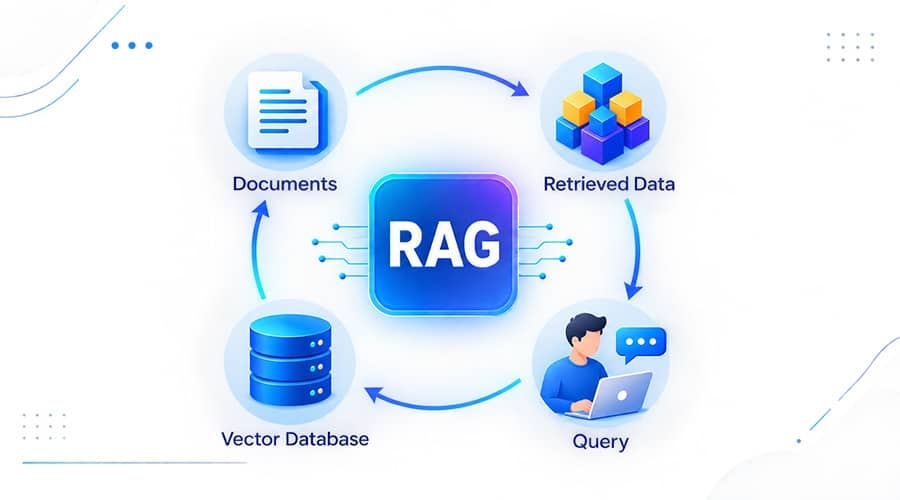
نقش پایگاهداده برداری در RAG و چتباتها
آمادهسازی: همه مقالات و اسناد به قطعات کوچک تقسیم و هر قطعه به یک بردار تبدیل میشود؛ سپس همه این بردارها در پایگاهداده برداری ذخیره میشوند.
ابزارهای رایج و اجرا در کنار ابر سیمرغ
امروزه پایگاهدادههای برداری متعددی وجود دارند که هر کدام برای نیازی مناسباند. مهمترین آنها عبارتاند از:
- FAISS: کتابخانهای متنباز و بسیار سریع از شرکت متا، مناسب برای اجرا روی زیرساخت خودی و پروژههای پژوهشی.
- Chroma: پایگاهدادهای سبک و متنباز که برای شروع سریع و پروژههای کوچک تا متوسط بسیار محبوب است.
- Milvus و Weaviate: پایگاهدادههای متنباز و مقیاسپذیر برای کاربردهای بزرگ و سازمانی.
- Pinecone: یک سرویس ابری مدیریتشده که راهاندازی آن ساده است اما داده روی سرورهای بیرونی قرار میگیرد.
برای سازمانهایی که با داده حساس کار میکنند یا میخواهند یک سامانه کاملاً بومی بسازند، اجرای پایگاهداده برداری متنباز روی زیرساخت خودی بهترین گزینه است. ساخت بردارها برای حجم زیادی از اسناد به منابع پردازشی قابلتوجهی نیاز دارد و اجرای مدل زبانی نیز اغلب به پردازنده گرافیکی نیازمند است. ابر سیمرغ با فراهمکردن منابع پردازش ابری مجهز به GPU، بستر مناسبی برای ساخت یک سامانه کامل RAG است؛ میتوانید مدل جاسازی، پایگاهداده برداری و مدل زبانی را روی سیمرغ مستقر کنید و یک چتبات اختصاصی، امن و کاملاً بومی بسازید. برای آشنایی بیشتر به وبسایت ابر سیمرغ مراجعه کنید.
جمعبندی
سوالات متداول
- تفاوت پایگاهداده برداری با پایگاهداده معمولی چیست؟
- جاسازی (Embedding) چیست؟
- آیا برای ساخت چتبات حتماً به پایگاهداده برداری نیاز دارم؟
- جستوجوی تقریبی نزدیکترین همسایه (ANN) چیست؟

اگر بازخوردی درباره این مطلب دارید یا پرسشی دارید که بدون پاسخ مانده است، آن را از طریق بخش نظرات مطرح کنید.
ثبت نظر