
مقدمه
مدلهای انکودری، دیکودری و انکودر-دیکودر
همانطور که در مقاله ترنسفورمر دیدیم، معماری اصلی این مدلها از دو بخش انکودر و دیکودر تشکیل شده است. مدلهای زبانی امروزی معمولاً بر پایه یکی از سه رویکرد زیر ساخته میشوند و شناخت این تفاوت برای انتخاب مدل پایه مناسب هنگام ریزتنظیم حیاتی است:
مدلهای دیکودری (Decoder-only)
این مدلها که خانواده GPT نمونه بارز آن هستند، متن را بهصورت یکطرفه و کلمهبهکلمه پیشبینی میکنند؛ یعنی با توجه به کلمات قبلی، کلمه بعدی را حدس میزنند. همین ویژگی آنها را برای وظایف تولید زبان ایدهآل میکند: تولید متن، گفتوگو، تکمیل کد و خلاصهسازی مولد. تقریباً تمام مدلهای مولد پرکاربرد امروزی از این نوع هستند.
این مدلها که T5 و BART از مشهورترین آنها هستند، هر دو بخش را دارند و برای وظایفی مناسباند که در آنها یک دنباله ورودی باید به یک دنباله خروجی متفاوت تبدیل شود؛ مانند ترجمه ماشینی یا خلاصهسازی. انکودر ورودی را درک میکند و دیکودر خروجی مناسب را تولید میکند.
- اگر هدف شما درک و تحلیل متن است به سراغ مدلهای انکودری بروید،
- اگر هدف شما درک و تحلیل متن است به سراغ مدلهای انکودری بروید،
- و اگر تبدیل یک متن به متن دیگر است مدلهای انکودر-دیکودر گزینه مناسب هستند.
ریزتنظیم (Fine-tuning) چیست و چرا به آن نیاز داریم؟
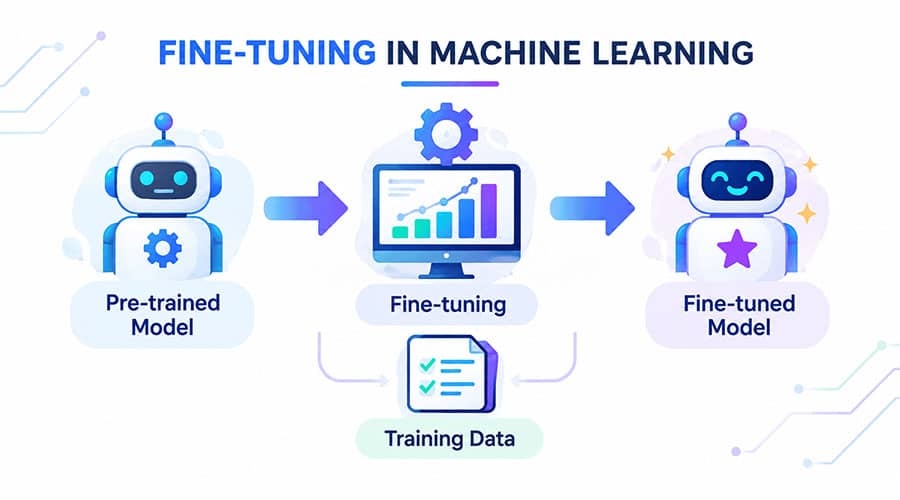
برای درک ریزتنظیم، باید ابتدا با مفهوم "یادگیری انتقالی" (Transfer Learning) آشنا شویم. ایده اصلی این است که بهجای آموزش یک مدل از صفر — که به میلیونها دلار هزینه و حجم عظیمی داده نیاز دارد — از یک مدل که پیشتر روی داده عمومی گسترده آموزش دیده (مدل "از پیشآموزشدیده" یا Pre-trained) شروع کنیم و تنها آن را با داده تخصصی خود تطبیق دهیم.
بنابراین فرایند کلی ساخت یک مدل کاربردی دو مرحله دارد:
- پیشآموزش (Pre-training): مدل روی حجم عظیمی از متن عمومی آموزش میبیند و دانش کلی زبان را میآموزد. این مرحله بسیار پرهزینه است و معمولاً توسط شرکتهای بزرگ انجام میشود.
- ریزتنظیم (Fine-tuning): مدل از پیشآموزشدیده را برمیداریم و آن را با مجموعه داده کوچکتر و تخصصی خود، برای یک وظیفه یا حوزه مشخص، دوباره و بهمقدار کم آموزش میدهیم.
-
تخصصگرایی: مدل عمومی را به یک متخصص در حوزه شما (مانند پزشکی، حقوقی و مالی) تبدیل میکند و دقت آن را در آن حوزه بهشدت بالا میبرد.
-
صرفهجویی در هزینه و زمان: بهجای صرف منابع عظیم برای آموزش از صفر، تنها با کسری از آن منابع به نتیجه مطلوب میرسیم.
-
انطباق با سبک و لحن: میتوان مدل را وادار کرد که با لحن، قالب یا زبان خاص سازمان شما پاسخ دهد.
-
کاهش نیاز به داده: چون مدل دانش زبانی را از قبل دارد، برای تخصصیشدن به داده بسیار کمتری نیاز دارد.
انواع روشهای ریزتنظیم
- ریزتنظیم کامل (Full Fine-tuning)
- ریزتنظیم کارآمد از نظر پارامتر (PEFT)
مهمترین روشهای این خانواده عبارتاند از:
- LoRA (تطبیق با رتبه پایین): محبوبترین روش PEFT است. بهجای تغییر وزنهای اصلی، ماتریسهای کوچک و کمرتبهای را در کنار لایههای مدل اضافه و تنها همانها را آموزش میدهد. با این کار میتوان مدلهای بسیار بزرگ را حتی روی یک کارت گرافیک معمولی ریزتنظیم کرد.
- QLoRA: نسخه بهینهتر LoRA که مدل پایه را بهصورت فشرده و کوانتیزهشده (مثلاً ۴ بیتی) در حافظه نگه میدارد و مصرف حافظه را باز هم کمتر میکند؛ بهطوریکه ریزتنظیم مدلهای بسیار بزرگ روی سختافزار محدود ممکن میشود.
- Adapter و Prompt Tuning: روشهای دیگری که در آنها لایههای کوچک واسط یا بردارهای راهنمای قابلآموزش به مدل افزوده میشوند، بدون آنکه بدنه اصلی مدل تغییر کند.
مراحل عملی یک پروژه ریزتنظیم
-
تعریف دقیق وظیفه: مشخص کنید مدل باید دقیقاً چه کاری انجام دهد (مانند دستهبندی، پاسخگویی و خلاصهسازی) و معیار موفقیت چیست.
-
آمادهسازی داده: مجموعه داده باکیفیت و مرتبط با وظیفه جمعآوری و پاکسازی کنید. کیفیت داده مهمترین عامل موفقیت است؛ حتی چند صد نمونه باکیفیت میتواند بهتر از هزاران نمونه نامرتب باشد.
-
انتخاب مدل پایه: بر اساس وظیفه (درک یا تولید) و منابع در دسترس، یک مدل از پیشآموزشدیده مناسب انتخاب کنید.
-
انتخاب روش و پیکربندی: تصمیم بگیرید ریزتنظیم کامل انجام میدهید یا PEFT، و ابرپارامترها (مانند نرخ یادگیری و تعداد دورهها) را تنظیم کنید.
-
آموزش و ارزیابی: مدل را آموزش دهید و با داده اعتبارسنجی که در آموزش استفاده نشده، عملکرد آن را بسنجید تا از بیشبرازش جلوگیری شود.
-
استقرار: مدل نهایی را برای استفاده واقعی بهکار بگیرید و عملکرد آن را در عمل پایش کنید.
یک مثال عملی با کتابخانه Hugging Face
قطعه کد زیر نشان میدهد که با کتابخانههای ترنسفورمرز و PEFT، ریزتنظیم یک مدل با روش LoRA چقدر ساده شده است. این نمونه ساختار کلی کار را نشان میدهد:
from transformers import AutoModelForCausalLM, TrainingArguments
from peft import LoraConfig, get_peft_model

# بارگذاری مدل پایه از پیشآموزشدیده
model = AutoModelForCausalLM.from_pretrained("base-model")

# پیکربندی LoRA: تنها ماتریسهای کوچک آموزش میبینند
lora_config = LoraConfig(r=8, lora_alpha=16,
                         target_modules=["q_proj", "v_proj"])
model = get_peft_model(model, lora_config)

# نمایش درصد پارامترهای قابلآموزش (معمولاً کمتر از ۱٪)
model.print_trainable_parameters()
# سپس مدل مانند حالت عادی آموزش داده میشود
همانطور که میبینید، با چند خط کد مدل پایه بارگذاری و پیکربندی LoRA روی آن اعمال میشود؛ پس از این مرحله تنها کسر بسیار کوچکی از پارامترها آموزش میبینند و بقیه ثابت میمانند.
اجرای ریزتنظیم روی زیرساخت و ابر سیمرغ
نمونه زیر یک اسکریپت SLURM برای اجرای یک کار ریزتنظیم روی یک GPU است:
#!/bin/bash
#SBATCH --job-name=finetune
#SBATCH --partition=gpu
#SBATCH --gres=gpu:1
#SBATCH --cpus-per-task=8
#SBATCH --time=08:00:00
#SBATCH --output=ft_%j.log

module load cuda/12.2
srun python finetune.py
ابر سیمرغ با ارائه گرههای مجهز به پردازنده گرافیکی، بستر مناسبی برای اجرای پروژههای ریزتنظیم فراهم میکند. میتوانید خدمات پردازش ابری مجهز به GPU (خدمات ابر هوش مصنوعی و خدمات پردازشگر گرافیکی) را از سیمرغ تهیه کنید، داده تخصصی خود را روی آن بارگذاری کنید و بدون نیاز به خرید سختافزار گرانقیمت، مدلهای زبانی را برای کاربردهای خاص خود ریزتنظیم کنید. این بهویژه برای سازمانها و پژوهشگرانی که میخواهند مدلهای اختصاصی فارسی یا حوزهمحور بسازند ارزشمند است. برای آشنایی بیشتر به وبسایت ابر سیمرغ مراجعه کنید.
چالشها و نکات مهم
- کیفیت داده: نامرتب یا مغرضانه بودن داده مستقیماً در رفتار مدل نهایی منعکس میشود؛ پاکسازی و بررسی دقیق داده ضروری است.
- بیشبرازش (Overfitting): اگر مدل بیش از حد روی داده کوچک آموزش ببیند، ممکن است بهجای یادگیری الگو، نمونهها را حفظ کند و در داده واقعی ضعیف عمل کند.
- فراموشی فاجعهبار: در ریزتنظیم کامل، مدل ممکن است دانش عمومی خود را از دست بدهد؛ روشهای PEFT این خطر را کاهش میدهند.
جمعبندی
ریزتنظیم پلی است میان قدرت عمومی مدلهای زبانی بزرگ و نیازهای تخصصی دنیای واقعی. با انتخاب درست خانواده مدل (انکودری، دیکودری یا انکودر-دیکودر) و روش مناسب ریزتنظیم (کامل یا کارآمد مانند LoRA)، میتوان با هزینه معقول، مدلهایی ساخت که در یک حوزه مشخص عملکردی بهمراتب بهتر از مدلهای عمومی دارند. کلید موفقیت، بیش از هر چیز، کیفیت داده و شناخت درست از هدف پروژه است.
در مقالههای بعدی به موضوعاتی مانند تفاوت ریزتنظیم با روش تولید تقویتشده با بازیابی RAG (بیشتر بخوانید)، و روشهای ارزیابی مدلهای ریزتنظیمشده خواهیم پرداخت.
سوالات متداول
- تفاوت ریزتنظیم با مهندسی پرامپت (Prompt Engineering) چیست؟
در مهندسی پرامپت تنها ورودی مدل را هوشمندانه طراحی میکنیم بدون تغییر خود مدل، اما در ریزتنظیم وزنهای مدل را با داده تخصصی بهروزرسانی میکنیم تا رفتار آن بهطور پایدار تغییر کند.
- برای ریزتنظیم به چه مقدار داده نیاز دارم؟
بستگی به وظیفه دارد، اما به لطف یادگیری انتقالی معمولاً از چند صد تا چند هزار نمونه باکیفیت برای رسیدن به نتیجه خوب کافی است.
- LoRA چیست و چرا محبوب است؟
LoRA روشی است که با آموزش تنها چند ماتریس کوچک بهجای کل مدل، ریزتنظیم مدلهای بزرگ را با حافظه و هزینه بسیار کمتر ممکن میکند و به همین دلیل به استاندارد عملی تبدیل شده است.
- چه زمانی بهجای ریزتنظیم از RAG استفاده کنم؟
اگر هدف افزودن دانش بهروز و قابلتغییر (مانند اسناد یک سازمان) است، RAG اغلب مناسبتر است؛ اما اگر هدف تغییر رفتار، لحن یا تخصص مدل در یک وظیفه است، ریزتنظیم گزینه بهتری است.

اگر بازخوردی درباره این مطلب دارید یا پرسشی دارید که بدون پاسخ مانده است، آن را از طریق بخش نظرات مطرح کنید.
ثبت نظر