
مقدمه
ابزارهایی مانند ChatGPT چگونه میتوانند متنی روان و معنادار تولید کنند، جملهها را ترجمه کنند یا به سوالات پاسخ دهند؟ پاسخ این پرسش در یک معماری هوش مصنوعی نهفته است که در سال ۲۰۱۷ معرفی شد و مسیر پردازش زبان طبیعی (مطالعه بیشتر) را برای همیشه تغییر داد: ترنسفورمر (Transformer). امروزه تقریباً همهی مدلهای زبانی بزرگ و مولد، از GPT گرفته تا BERT، بر پایهی همین معماری ساخته شدهاند.
Transformer چیست؟
چرا ترنسفورمر یک انقلاب بود؟
پیش از ترنسفورمر، برای پردازش متن عمدتاً از شبکههای عصبی بازگشتی (RNN) و LSTM استفاده میشد. این روشها کلمات را یکییکی و بهصورت ترتیبی پردازش میکردند که دو مشکل بزرگ داشت: کندی (بهدلیل نبود موازیسازی) و فراموشی وابستگیهای دور در جملههای طولانی. ترنسفورمر این مشکلات را به این شکل حل کرد:
- پردازش موازی: بهجای پردازش کلمه به کلمه، کل جمله را همزمان پردازش میکند و همین باعث میشود آموزش مدل روی پردازندههای گرافیکی بسیار سریعتر انجام شود.
- درک وابستگیهای دور: با مکانیزم توجه، ارتباط میان کلماتی که فاصلهی زیادی در جمله دارند به خوبی حفظ میشود.
- مقیاس پذیری: این معماری به خوبی با افزایش حجم داده واندازه مدل بزرگ میشود؛ همین ویژگی ظهور مدلهای زبانی بزرگ (LLM) را ممکن کرد.
مکانیزم توجه (Attention) چگونه کار میکند؟
قلب تپنده ترنسفورمر، مکانیزم "خودتوجهی" (Self-Attention) است. برای درک ساده آن، جملهی "گربه روی فرش نشست چون خسته بود" را در نظر بگیرید. وقتی مدل به کلمهی "خسته" میرسد، باید بفهمد این کلمه به "گربه" اشاره دارد نه فرش. مکانیزم توجه دقیقاً همین کار را انجام میدهد: برای هر کلمه مشخص میکند که باید به کدام کلمات دیگر و با چه شدتی توجه کند.
این کار با سه مفهوم انجام میشود که برای هر کلمه ساخته میشوند:
- پرسوجو (Query): نماینده این پرسش است که "من به دنبال چه اطلاعاتی هستم؟"
- کلید (Key): برچسبی است که نشان میدهد هر کلمه "چه اطلاعاتی دارد."
- مقدار (Value):محتوای واقعی اطلاعاتی است که هر کلمه ارائه میدهد
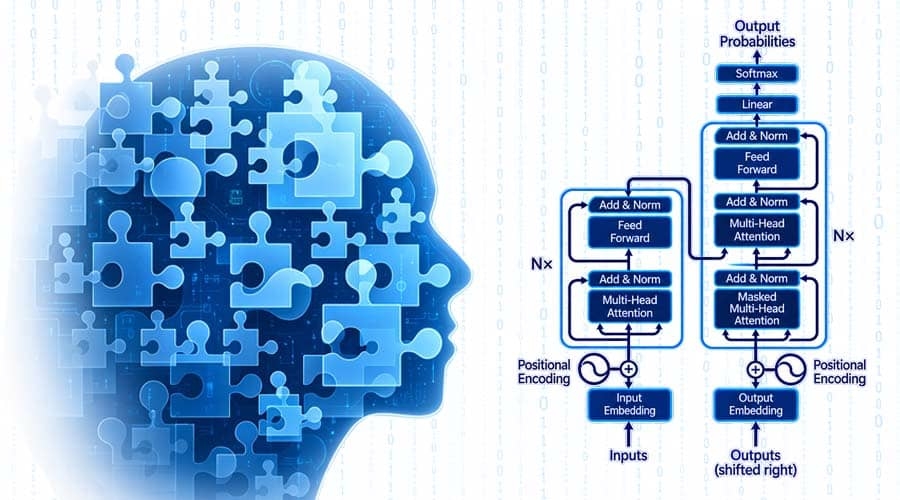
ساختار کلی معماری ترنسفورمر
معماری اصلی ترنسفورمر از دو بخش اصلی تشکیل شده است:
- رمزگذاری (Encoder): وظیفه درک و رمزگذاری متن ورودی را بر عهده دارد و آن را به یک نمایش معنایی غنی تبدیل میکند.
- رمزگشایی (Decoder): بر اساس نمایش تولیدشده توسط رمزگذار، خروجی (مثلاً ترجمه یا ادامهی متن) را کلمهبهکلمه تولید میکند.
کاربردها و مدلهای مبتنی بر ترنسفورمر
ترنسفورمر بهسرعت از حوزه ترجمهی ماشینی فراتر رفت و به معماری غالب در بسیاری از زمینهها تبدیل شد. مهمترین کاربردها و مدلها عبارتاند از:
- مدلهای زبانی بزرگ: خانوادهی GPT (پایهی ChatGPT)، BERT، LLaMA و بسیاری دیگر همگی بر پایه ترنسفورمر هستند.
- پردازش تصویر: مدلهای Vision Transformer (ViT) نشان دادند که این معماری در بینایی کامپیوتر نیز بسیار قدرتمند است.
- سایر حوزهها: از تولید تصویر و صوت گرفته تا تحلیل دادههای زیستی مانند ساختار پروتئینها.
آموزش این مدلها به دلیل حجم عظیم داده و پارامترها، به منابع پردازشی بسیار قدرتمند بهویژه پردازندههای گرافیکی نیاز دارد. ابر سیمرغ با فراهمکردن زیرساخت پردازش ابری مجهز به GPU ،بستر مناسبی برای آموزش و اجرای مدلهای مبتنی بر ترنسفورمر فراهم میکند؛ میتوانید منابع موردنیاز خود را از سیمرغ تهیه کرده و پروژههای یادگیری عمیق خود را با کارایی بالا اجرا کنید. برای آشنایی بیشتر به وبسایت ابر سیمرغ مراجعه کنید.
جمعبندی
ترنسفورمر با معرفی مکانیزم توجه و پردازش موازی، محدودیتهای روشهای پیشین را کنار زد و راه را برای انقلاب هوش مصنوعی مولد هموار کرد. درک این معماری و بهویژه ایدهی «توجه»، کلید فهم این است که مدلهای زبانی امروزی چگونه کار میکنند و چرا اینقدر قدرتمند هستند.
در مقالههای بعدی به موضوعاتی مانند تفاوت مدلهای رمزگذاری و رمزگشایی، فرایند تنظیم دقیق یا ریزتنظیم (Fine-tuning) مدلهای زبانی و کاربرد عملی آنها خواهیم پرداخت.
سوالات متداول
- تفاوت ترنسفورمر با شبکههای عصبی بازگشتی (RNN) چیست؟
RNNها متن را کلمهبهکلمه و ترتیبی پردازش میکنند، اما ترنسفورمر کل جمله را همزمان و موازی پردازش میکند و وابستگیهای دور را بهتر درک میکند.
- مکانیزم توجه (Attention) به زبان ساده چیست؟
سازوکاری است که به مدل اجازه میدهد هنگام پردازش هر کلمه، مشخص کند به کدام کلمات دیگر جمله و با چه شدتی توجه کند تا معنای درست را درک کند.
- آیا GPT و BERT هر دو ترنسفورمر هستند؟
بله، هر دو بر پایهی ترنسفورمر ساخته شدهاند؛ GPT از بخش رمزگشا و BERT از بخش رمزگذار این معماری استفاده میکند.
- چرا آموزش مدلهای ترنسفورمر به GPU نیاز دارد؟
بهدلیل حجم عظیم محاسبات موازی و تعداد بسیار زیاد پارامترها، پردازندههای گرافیکی که برای محاسبات موازی بهینهاند، برای آموزش این مدلها ضروری هستند.

اگر بازخوردی درباره این مطلب دارید یا پرسشی دارید که بدون پاسخ مانده است، آن را از طریق بخش نظرات مطرح کنید.
ثبت نظر